He estado construyendo una fábrica de software con 15 suscripciones de Codex, trabajando en una docena de proyectos de software durante el último mes. En este post voy a profundizar en mi filosofía sobre programar con IA, cómo construí mi fábrica de software (incluido mi stack técnico completo) y una visión general de mis proyectos.
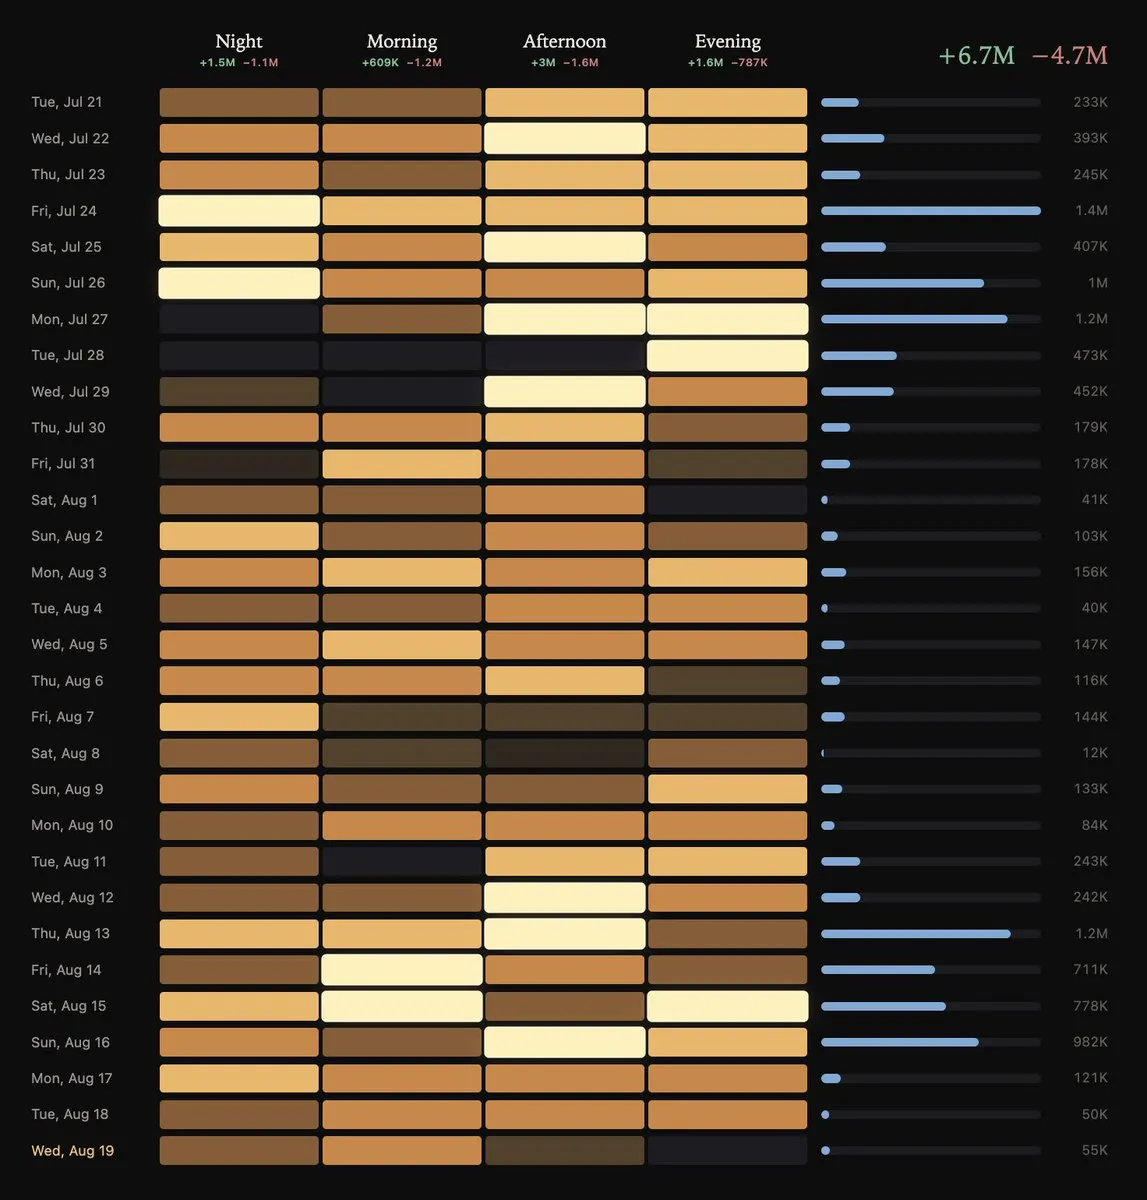
Mi fábrica produjo +6,7 M y −4,7 M líneas de código este mes
Paso 1: usa los mejores tokens de la forma más eficiente
Debes buscar apalancamiento sin descanso para que la mayor parte de tu tiempo se dedique a problemas difíciles, no a cuidar la ejecución.
La eficiencia de tokens es clave. Los mejores modelos open-source siguen por detrás de los modelos cerrados cuando se tienen en cuenta los fuertes subsidios de los grandes laboratorios. Al escribir código, siempre debes usar el ~mejor modelo disponible en la frontera de Pareto [0], teniendo en cuenta los subsidios [1].
Yo ejecuto 15 suscripciones de Codex Pro 20x [2]. Si usamos el subsidio de 70× que SemiAnalysis reportó en junio, estoy gastando 210 000 $/mes en inferencia premium. Es una tasa anual de 2,5 M$ — por solo 36 000 $ [3].
I currently have 15 Codex Pro 20x subscriptions. This means I’m leveraging $210k/mo cooking with the finest models – a run rate of $2.5M yearly. And I'm paying $36k, which is less than minimum wage in Washington State. (70x subsidy reported by @SemiAnalysis_ in June)
a portrait of my software factory over the last 30d my yield was +6.7M and -4.7M lines of code over 25 projects my factory is 2x more productive in the afternoon and least productive in the morning some days i just let it ride but i'm trying to be on the factory floor more
[0] Sigo la frontera de Pareto de capacidad de modelos en aicharts.io (sin contar subsidios). La selección del modelo es crítica cuando tus agentes escriben código de producción. Optimiza por calidad sobre coste o velocidad. Cuando escatimas en calidad de modelo, acabas perdiendo tiempo (y tokens) a la larga.
[1] Cuando hice una comparación entre Claude Max y Codex Pro 20x, pude usar GPT 5.6 Sol (Max/Ultra) durante mucho más tiempo del que pude usar Fable.
[2] Gestionar 15 suscripciones es algo engorroso, así que construí un CLI sencillo sobre Codex App Server para seguir mis cuentas. También estoy construyendo un meta-arnés llamado Hra, que me permite agrupar mis suscripciones y experimentar con ideas de arquitectura e interfaz de agentes ajustadas a mis restricciones particulares.
[3] 36 000 $ puede sonar a mucho dinero, pero es mucho menos que el salario de un ingeniero humano.
Paso 2: construye una base de conocimiento
Los codebases tienen una inteligencia propia. Codifican un sistema de reglas y creencias, con vetas profundas de conocimiento tácito.
Desde el principio decidí construir una base de conocimiento (kb) para mi fábrica. En datos, kb es simple: archivos markdown con backlinks y una base de datos SQLite. En código [0], kb da a los agentes herramientas para buscar conocimiento de forma más eficiente combinando búsqueda de texto completo, etiquetas, búsqueda semántica [1], búsqueda en grafo y contexto de git.
Esto ha funcionado de maravilla en mi fábrica. Los agentes registran planes y decisiones en kb. Esto les ayuda a aprender con el tiempo. En la capa de orquestación de agentes, creo que el aprendizaje continuo está resuelto. Simplemente da a los agentes la capacidad de coordinarse entre sí a través del tiempo y el espacio. Ellos lo resolverán.
[0] Diseño todas mis herramientas de agente con interfaces CLI y SDK. El SDK permite a los agentes escribir código para invocar la herramienta, lo que abre todo un universo nuevo de posibilidades.
[1] Para la búsqueda semántica uso qmd y un modelo de embeddings local, EmbeddingGemma 300M.
Paso 3: mejora la escritura de tu agente
Al hacer crecer un codebase de alta calidad con LLM, debes anclar el modelo en la parte inteligente de su distribución de entrenamiento.
Como gran parte de un codebase es prosa y no código (comentarios, commits, documentación, etc.), debes asegurarte de que toda tu prosa sea de alta calidad. Cuando lo haces, notarás la diferencia en la calidad de tus conversaciones y en el tacto de tu código. Cuando tus entradas se parecen al trabajo de alguien con buen gusto, descubrirás que esto activa circuitos más inteligentes en el LLM, y tus salidas mejorarán.
Yo uso dos archivos markdown para lograr mejor prosa: WRITING.md para prosa interna y STYLE.md para el texto externo.
Paso 4: elige un stack técnico sólido
Mis agentes ahora corren durante horas, a veces incluso días. Despacho prompts al despertar, a la hora de comer, después de cenar y antes de dormir. ¿Cómo lo conseguí?
Programar con agentes es como jugar al golf. Primero elegí un stack técnico sin complicaciones [0] y establecí mis convenciones de código preferidas [1]: mejorar la precisión de mi swing. Una vez que tuve una base sólida, permití a los agentes verificar el trabajo por sí mismos: mejorar la potencia de mi swing.
Creé un framework de tests de UI propio llamado direct, que permite a los agentes simular y verificar estados de la app. direct se sitúa en la costura entre tu app e internet. Da a los agentes una forma eficiente de grabar flujos de UI amañados y verificarlos con eficiencia. El éxito de direct en mi fábrica me inspiró, así que construí una herramienta de automatización de navegador llamada ghostget [2]. Uso ghostget sobre todo para automatizaciones personales, pero ocasionalmente es útil para automatizar flujos de desarrollo donde no hay una API oficial disponible.
Plataforma de desarrollo compartida: UI, cuentas, pagos, observabilidad
«Make invalid states hard to represent.»
«Keep dependencies deliberate. Separate shared foundations from product composition.»
«Prefer coherent cross-file correctness and focused deterministic evidence to a knowingly weaker design.»
«Treat production risk, rollout, monitoring, provider access, and external coordination as real costs.»
«Keep ownership documented. Each source boundary gets an AGENTS.md with exactly # CONTENTS and #GUIDELINES. Plans, notes, and runbooks belong in kb.»
«Record future work in a verifiable plan under kb/plans.»
[2] ghostget está inspirado en la skill derive-client de agent-browser; permite a los agentes hacer crecer un SDK para cualquier sitio web.
Paso 5: deja que los agentes cocinen
Mi fábrica estaba lista, así que decidí apuntarla a algunos proyectos de infraestructura personal. Primero hice la web personal de mis sueños. Luego imaginé más proyectos. Acumulé 94 dominios nuevos en 1 mes.
Recientemente empecé a usar Grok Bot. Como creador de Zo Computer, conozco el espacio a fondo: fuimos el primer agente personal con un ordenador en la nube. Llevo tiempo respetando a Benji Taylor y al equipo de Cursor, así que me entusiasmó probar Bot. El uso del ordenador es elegante, el agente es rápido y la interfaz es simple y deliciosa.
ok damn @cursor_ai mogged everyone with @bot i kneel
Enchufando herramientas caseras de mi fábrica de software, he generado un montón de agentes útiles en mi Grok Bot:
GhostGet – En el navegador de Bot inicié sesión en X, Substack, Bluesky, Instagram, Threads, Facebook, Reddit, YouTube y Hacker News. Le pido a GhostGet Bot que navegue, resuma y publique en las plataformas sociales, ahorrándome el brainrot.
Read – Mi web personal incluye una lista de lectura viva que resume todos los enlaces interesantes que encuentro. El contenido completo de cada artículo, vídeo o PDF se guarda en mi kb, así que mis agentes tienen contexto completo sobre mis intereses. Y los artículos de mi kb se sincronizan automáticamente con mi web. Hoy en día solo envío enlaces a Read Bot, responde con un resumen útil y sé que efectos secundarios útiles están ocurriendo en segundo plano.
Invest – Conecté mi cuenta de Public y le pedí a Invest Bot que ideara una estrategia de portafolio (guardada en kb) y la ejecutara de forma autónoma, despertando para iterar 3 veces al día. Veremos cómo va.
Stripe – Soy un gran fan de Stripe, así que construí hraness.com/stripe para catalogar las noticias de Stripe desde sus inicios. Stripe Bot me avisa cuando ocurre algo digno de noticia.
News – Hice un agregador de las noticias que me interesan en rough.day. News Bot me envía un resumen cada día.
Atet – Estoy construyendo un toolkit de media agéntico llamado Atet, llamado así por la barca solar en la que Ra navega por el inframundo. atet crea imágenes, diagramas y vídeos de forma iterativa, usando una mezcla de técnicas generativas y de código. Hablo con Atet Bot para transmutar assets en bruto e ideas en oro mediático.
People – Estoy construyendo un rolodex agéntico llamado PeopleBlade. He ingerido todos mis contactos (con metadatos útiles, como con qué frecuencia he interactuado con una persona) de iMessages, Apple Contacts, Gmail, LinkedIn, Telegram, WhatsApp, Instagram y Facebook. PeopleBlade me permite sincronizar mi rolodex con la nube y enriquecer miles de contactos de toda mi vida.
SEO – Conecté PostHog, y ahora SEO Bot mejora iterativamente el SEO en todas mis propiedades web.
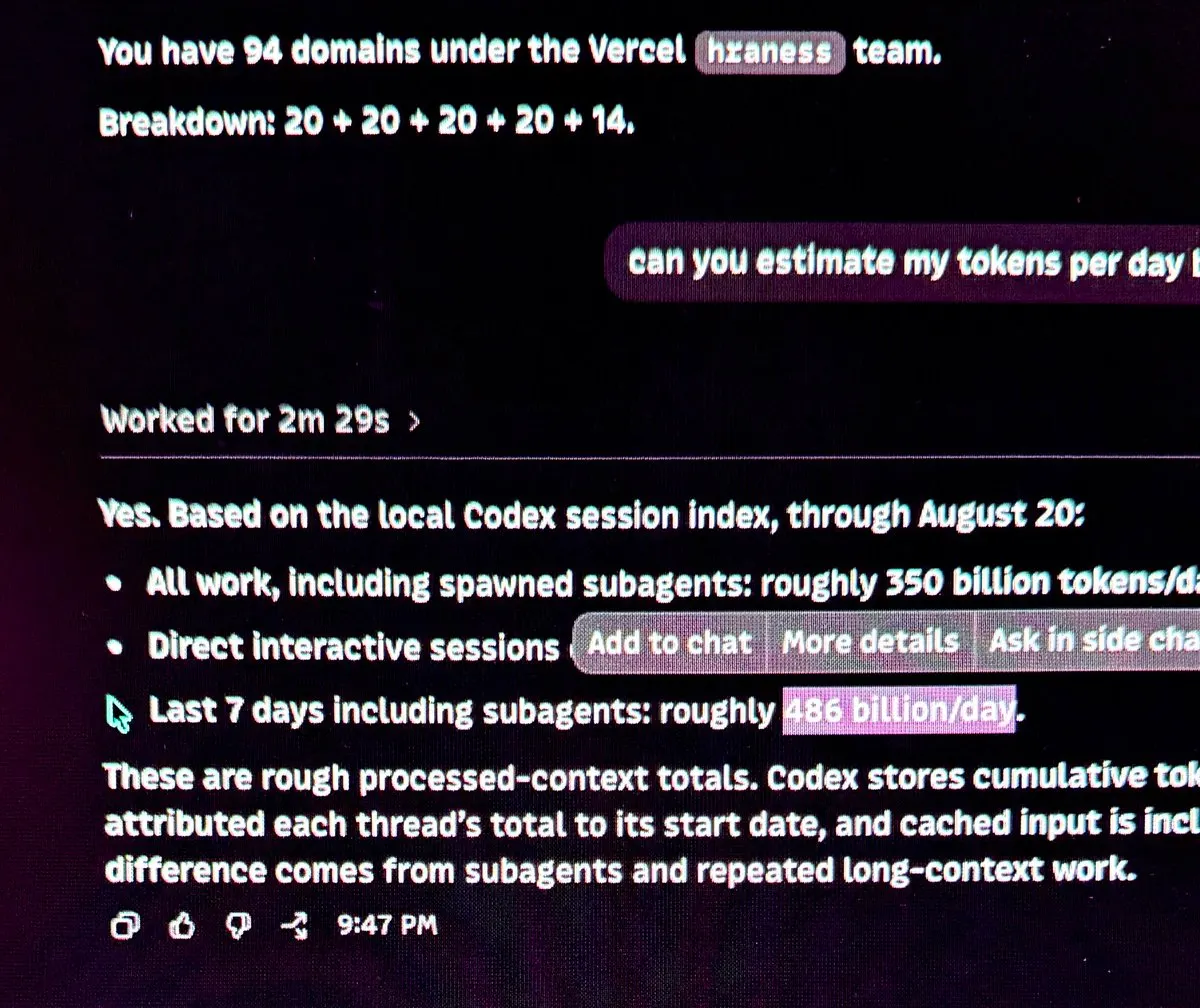
Estoy gastando medio billón de tokens al día, y acabo de empezar. Ahora que terminé la fase 1 de mi fábrica de software, he empezado a cocinar proyectos más ambiciosos. Más sobre eso pronto.